中英双语,稳定转写
在公开中文与英文评测中,平均错误率分别为 3.55 和 3.99。下图分别比较中文 CER 与英文 WER。
中英双语识别每行上柱为中文 CER,下柱为英文 WER;两项分别比较,不合并计算。
听懂中英文、方言,也听懂上下文。
中英文转写 · 方言识别 · 热词与对话上文增强
一个模型,识别中英文、方言与真实场景中的复杂语音。加入热词或对话上文,帮助听清陌生的人名、地名与专业术语。
公开中文评测平均
公开英文评测平均
自建方言评测平均
五领域算术均值
通过这段短片了解 Ming-3.0-asr-tiny 的语音识别能力与使用场景。
从通用中英转写、地方方言,到热词与对话上文增强,Ming-3.0-asr-tiny 将不同语音识别需求融入同一模型。下面分别展示四项核心能力及对应指标,完整结果见评测部分。
在公开中文与英文评测中,平均错误率分别为 3.55 和 3.99。下图分别比较中文 CER 与英文 WER。
中英双语识别每行上柱为中文 CER,下柱为英文 WER;两项分别比较,不合并计算。
方言测试集平均错误率为 8.42,低于 Qwen3-ASR-1.7B 的 15.30,接近 Fun-ASR 1.5 的 8.00。
方言覆盖采用评测图公布的方言平均值;不同方言的单项结果见完整评测图。
支持以热词和对话上文辅助识别专有名词与领域术语。Context ASR 综合 Average 为 4.36,与 Qwen3-Omni 的 4.34 接近。
上下文增强识别Average 为评测图中的综合指标,不等同于单项 WER,也不表示有无上下文的提升幅度。
覆盖聊天、政务、健康、知识、本地生活及高噪场景。五领域平均错误率为 1.67,在图中所列模型中最低。
真实场景评测对聊天、政务、健康、知识、本地生活的错误率等权平均。
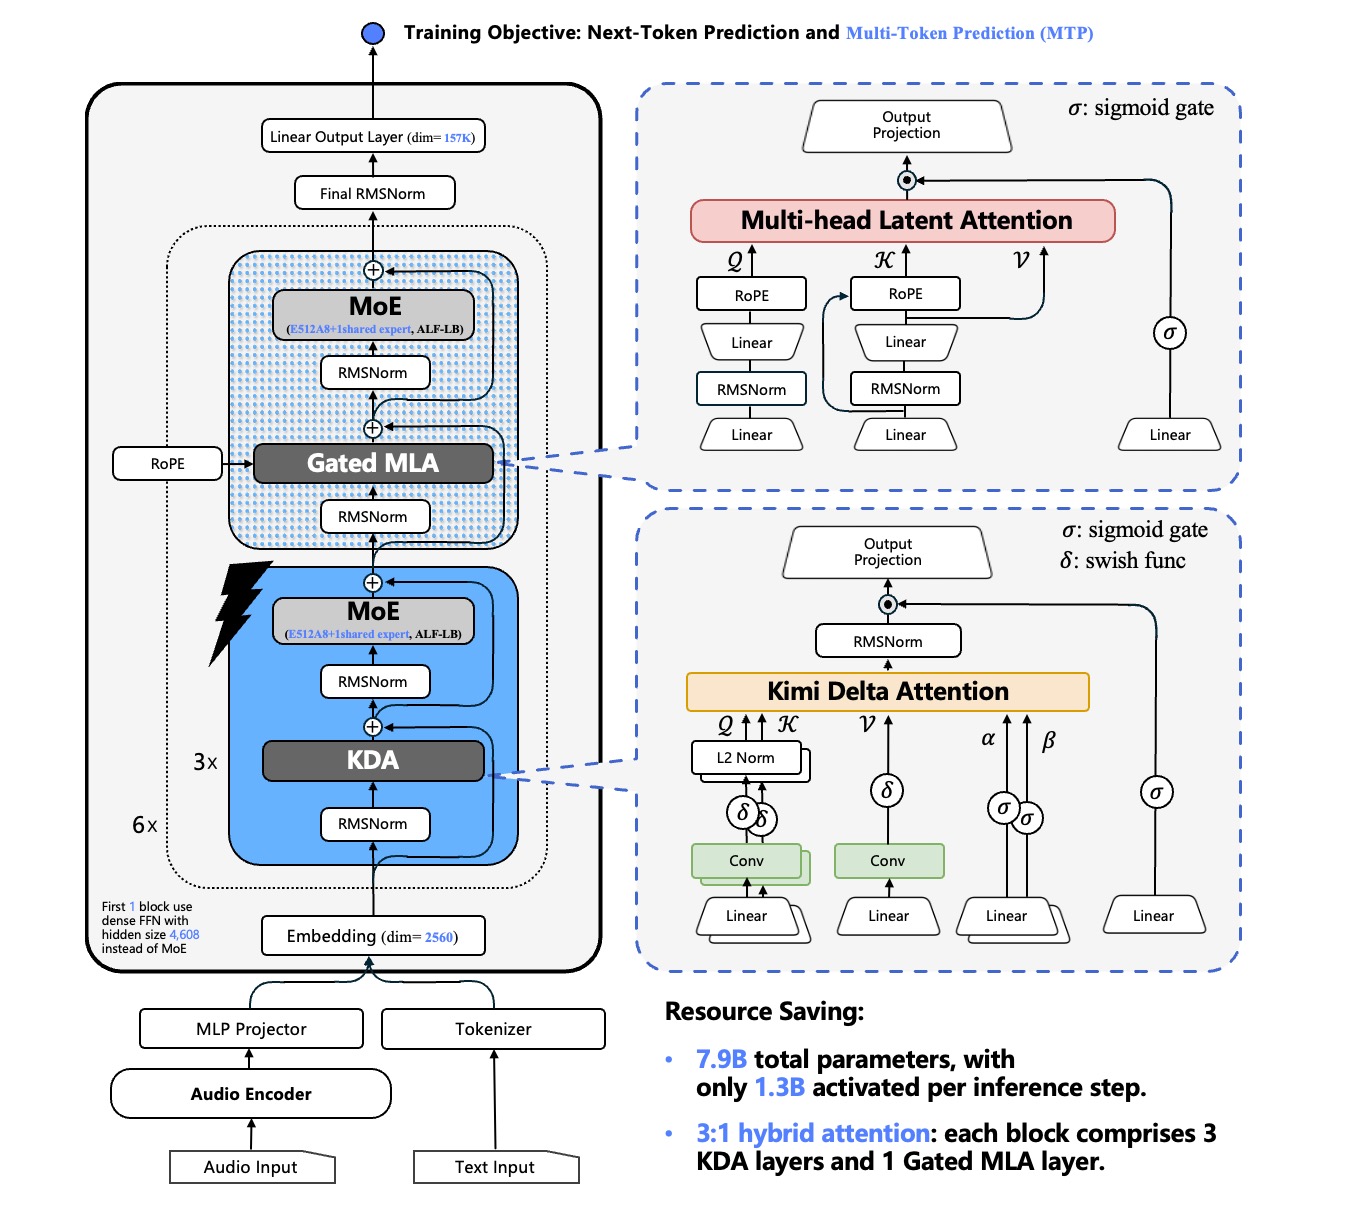
Audio Encoder × Ling-tiny-v3

音频经过 Audio Encoder 与 MLP Projector,文本通过 Tokenizer,汇入语言模型完成转写。
采用 3 层 Kimi Delta Attention 与 1 层 Gated MLA 的组合,并结合 MoE 结构。
使用相关热词或前序对话引导领域术语识别。长音频可分块编码,仍受模型上下文长度限制。
模型架构详见上图;评测结果见下方原始评测图。
试听三段语音样例,比较参考文本与识别结果。
下面的音频可以直接试听。参考文本与识别结果均去除标点,英文统一为小写,方便并排比较。识别结果来自 HF 模型的单条推理,不代表整体评测成绩。样例中的转写文本、主题和热词保留原语言。
python examples/transcribe.py --model "$MODEL_DIR" \
--audio examples/cases/audio/chinese_common_voice.wavpython examples/transcribe.py --model "$MODEL_DIR" \
--audio examples/cases/audio/english_common_voice.wav同一段音频,仅第二次加入主题与热词。
python examples/transcribe.py --model "$MODEL_DIR" \
--manifest examples/cases/context.jsonl \
--output outputs/context-demo.jsonl \
--language-hint zh --max-new-tokens 256音频来源:Context 样例来自 ContextASR-Bench;中英文样例来自 Mozilla Common Voice。音频来源说明
中英文、方言、领域与上下文语音识别的评测表现,点击图片可放大查看。
所有错误率指标均越低越好。通用识别、方言与 Context ASR 分别按对应指标比较。
中英文、方言与领域识别概览
中英双语识别
方言与业务领域
上下文增强语音识别
inclusionAI/Ming-3.0-asr-tiny模型使用与许可信息以项目仓库中的当前说明为准。
在仓库根目录运行以下命令与 Python 示例。
验证环境:Python 3.12 · Linux · Transformers 5.12.1 · fla-core 0.5.2 · PyTorch 2.11.0+cu130。推理需要支持 KDA 内核的 CUDA GPU。模型依赖以下载目录中的 requirements.txt 为准;GitHub 仓库提供文档、图表和调用示例,完整权重从 Hugging Face 下载。
python -m pip install "huggingface_hub[cli]"
hf download inclusionAI/Ming-3.0-asr-tiny --local-dir ./Ming-3.0-asr-tiny-model
export MODEL_DIR=./Ming-3.0-asr-tiny-model
python -m pip install -r "$MODEL_DIR/requirements.txt"
python tools/verify_repository.py --checkpoint "$MODEL_DIR"python examples/transcribe.py \
--model "$MODEL_DIR" \
--audio /path/to/speech.wav \
--output outputs/transcript.json与仓库可执行脚本使用相同的核心调用。将 speech.wav 换成自己的音频文件。
import soundfile as sf
import torch
from transformers import AutoModelForCausalLM, AutoProcessor
from examples.hf_runtime import decode_transcript, prepare_asr_request
checkpoint = "./Ming-3.0-asr-tiny-model"
processor = AutoProcessor.from_pretrained(checkpoint, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
checkpoint, trust_remote_code=True, dtype=torch.bfloat16,
device_map="cuda:0", attn_implementation="sdpa",
).eval()
waveform, sample_rate = sf.read("speech.wav", dtype="float32", always_2d=True)
inputs = prepare_asr_request(processor, (waveform.T, sample_rate)).to(model.device)
with torch.inference_mode():
eos = model.config.text_config.eos_token_id
output = model.generate(
**inputs, max_new_tokens=256, do_sample=False,
eos_token_id=eos, pad_token_id=eos, no_repeat_ngram_size=10,
)
print(decode_transcript(
processor.tokenizer, output[0, inputs.input_ids.shape[1]:].tolist(),
))普通转写和 Context ASR 默认使用同一种音频输入格式:cuda:0、BF16、SDPA、greedy decoding、10-gram 重复限制和最多 256 个新 token。Context ASR 仅在 <AUDIO> 前连续拼接主题、热词或上文,--device 和 --max-new-tokens 可按需调整。
音频混音并重采样至 16 kHz,长音频按块编码,输入和输出总长度仍受上下文限制。输出为纯文本,不提供词级时间戳或说话人分离,不支持图像和视频输入;当前验证范围不包含量化、分布式生成与流式音频输入。
@misc{ming_3_0_asr_tiny_2026,
author = {{inclusionAI}},
title = {Ming-3.0-asr-tiny: Context-Aware Speech Recognition},
year = {2026},
url = {https://github.com/inclusionAI/Ming-3.0-asr}
}